If you read our previous article Easy Ubuntu Server Firewall, then you may have noted that on Ubuntu 16.04 the described method no longer works. This is due to systemd. In the article below we will walk through creating a persistent IPTables based firewall on Ubuntu 16.04 LTS. First we need to install some required software packages. As seen in the command below, install iptables-persistent. Next we will make netfilter-persistent run at boot. This is the most important step as it will ensure your rules are reloaded at boot time.
# Install IPTables Persistent Package
apt-get install-y iptables-persistent
# Add netfilter-persistent Startup
invoke-rc.d netfilter-persistent save
# Stop netfilter-persistent Service
service netfilter-persistent stop
Once the packages above are installed and the service is stopped, you will have a new directory at /etc/iptables/. This directory holds the IPTables filter rules that will be reloaded at boot time. These files are named rules.v4 and rules.v6 respectively. IPV4 rules are loaded into rules.v4 and IPV6 rules are loaded into rules.v6. For the purpose of this article we will focus on IPV4 rules. Next we will want to copy the rules below into our rules.v4 file. Of course the rules will need to be modified to fit your environment.
# Generated by iptables-save v1.3.3 on Wed Apr 9 10:51:08 2008
# Flush out any rules that are already in there
*filter
:INPUT ACCEPT [146:11332]
:FORWARD ACCEPT [0:0]
:OUTPUT ACCEPT [104:9831]

# Allow internal loopback connections
-A INPUT -i lo -j ACCEPT
-A OUTPUT -o lo -j ACCEPT

# Allow pinging
-A INPUT -p icmp -m icmp --icmp-type 8 -j ACCEPT

# Allow any outbound data, and any inbound data related to a connection that is already in use
-A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
-A OUTPUT -m state --state NEW,RELATED,ESTABLISHED -j ACCEPT

# =========BEGIN SERVER SPECIFIC PORT OPEN RULES=========
# Allow SCP/SSH Access from Green & Blue Subnet
-A INPUT -s 172.16.12.0/255.255.255.0 -p tcp -m tcp --dport 22 -j ACCEPT
-A INPUT -s 10.10.12.0/255.255.255.0 -p tcp -m tcp --dport 22 -j ACCEPT

# Allow HTTP Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 80 -j ACCEPT

# Allow HTTPS Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 443 -j ACCEPT

# Allow MySQL Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 3306 -j ACCEPT

# Allow FTP Access from Red Subnet/Internet
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 21 -j ACCEPT
-A INPUT -p tcp -m state --state NEW,ESTABLISHED --dport 58000:58010 -j ACCEPT
# =========END SERVER SPECIFIC PORT OPEN RULES=========

# Drop everything that hasn't been picked up by one of the rules above
-A INPUT -j DROP
-A FORWARD -j DROP
-A OUTPUT -j DROP

COMMIT
# Completed on Wed Apr 9 10:51:08 2008
Lastly, in order for our new rules to take affect, we simply need to start the netfilter-persistent service as seen below. That’s it, you now have a fully functional IPTables based firewall.
# Start netfilter-persistent Service
service netfilter-persistent start

# Check if IPTables were applied
iptables -L
The setup described here is compatible with any Ubuntu LAMP server, so you can use this one as the basis setup too.
This tutorial will show you how to setup Let’s Encrypt on Servers without ISPConfig 3 as there will be a direct implementation of the Let’s Encrypt service in the next ISPConfig 3 release (version 3.1) soon. So if you plan to use ISPConfig, wait for the 3.1 release and also a new tutorial.
Creating the website
The 1st step is to create the website configuration and directory and enable SSL (Apache mod_ssl) for it. It’s up to you if you use the default configuration for one website on a server or you plan to use multiple vhosts to host more than one domain. For more reliable and scalable usage, I’ll create a vhost configuration for my “lab” domain isp1.cloudapp.net from Azure.
Vous avez des serveurs, une box domotique, un NAS ou quelques conteneurs Docker, et vous voulez voir d’un coup d’œil ce qui s’y passe : charge CPU, mémoire, températures, consommation électrique, logs ? Grafana est l’outil de référence pour ça. Dans cet article, je vous explique à quoi il sert, pourquoi il vaut le coup, et comment l’installer en quelques minutes avec Docker.
Qu’est-ce que Grafana ?
Grafana est une application web libre (open source) de visualisation de données et de supervision. Elle ne stocke pas vraiment vos données : elle se branche sur des sources de données (Prometheus, InfluxDB, Loki, MySQL/MariaDB, PostgreSQL, Elasticsearch, etc.) et vous permet de construire des tableaux de bord composés de graphiques, jauges, tableaux, cartes ou indicateurs.
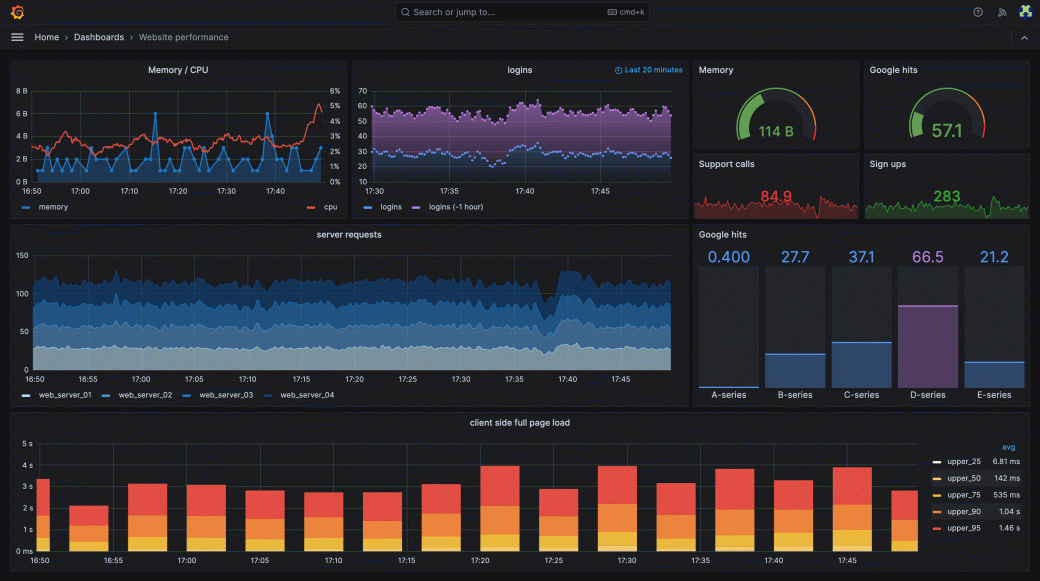
Un tableau de bord Grafana (image : Grafana Labs)
Pourquoi utiliser Grafana ?
Un seul outil pour plusieurs sources : vous pouvez afficher sur la même page des métriques Prometheus, des données d’une base SQL et des logs Loki.
Des tableaux de bord prêts à l’emploi : la communauté en partage des milliers sur grafana.com. Un import par identifiant et vous obtenez un tableau de bord complet.
Des alertes : Grafana peut vous prévenir (e-mail, Telegram, webhook, etc.) quand un disque est plein ou qu’un service ne répond plus.
Gratuit et auto-hébergeable : l’édition open source suffit amplement pour un usage personnel, un homelab ou une petite structure.
Extensible : de nombreux plugins ajoutent des types de graphiques et des sources de données.
Léger à déployer avec Docker : une image officielle, un volume pour les données, et c’est parti.
Quelques exemples d’usage
Surveiller la santé d’un serveur ou d’un NAS (CPU, RAM, disques, réseau).
Suivre des conteneurs Docker (avec cAdvisor).
Visualiser une consommation électrique ou des températures issues de la domotique.
Analyser des logs applicatifs ou de pare-feu.
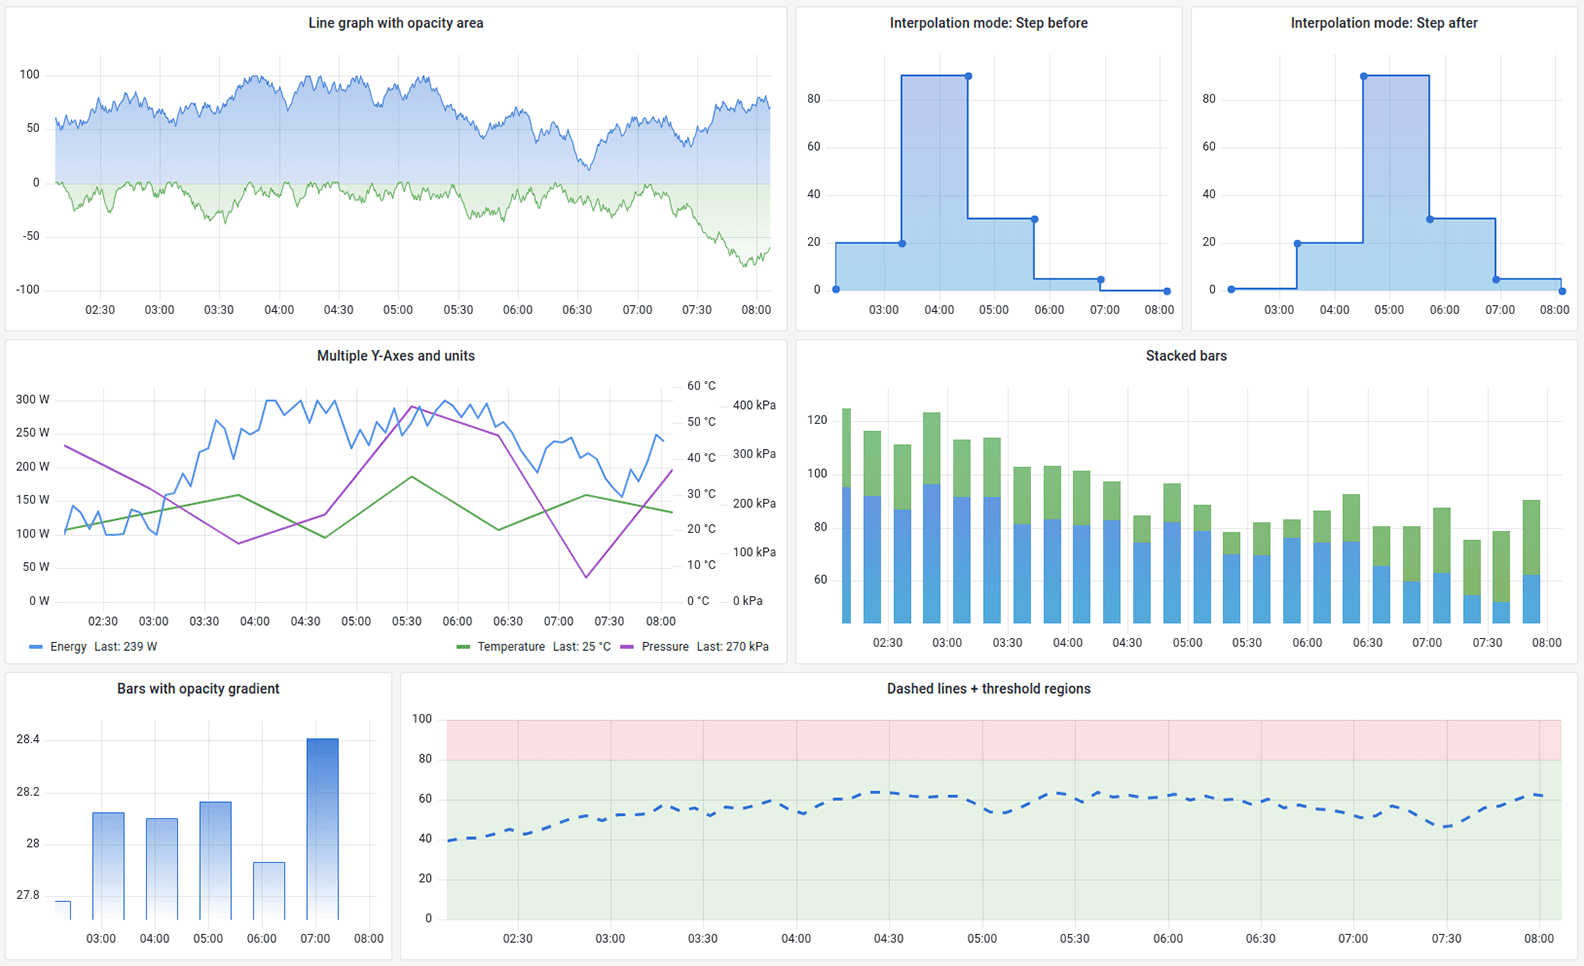
Visualisation de séries temporelles (image : Grafana Labs)
Installer Grafana avec Docker
Prérequis
Un serveur ou une machine Linux (un mini-PC, un Raspberry Pi 4/5, une VM…).
Docker Engine et le plugin Docker Compose installés. Vérifiez avec :
docker --version
docker compose version
Méthode 1 : un essai rapide en une commande
Pour tester Grafana sans rien configurer :
docker run -d -p 3000:3000 --name=grafana grafana/grafana
Le conteneur démarre en arrière-plan (-d) et publie le port 3000 (-p 3000:3000). Attention : sans volume, vos tableaux de bord sont perdus si vous supprimez le conteneur. Pour un vrai usage, passez à la méthode 2.
Méthode 2 : Docker Compose (recommandée)
Étape 1 – Créer le dossier du projet
mkdir -p ~/grafana && cd ~/grafana
Étape 2 – Créer le fichier .env (il contient le mot de passe administrateur, à ne pas partager) :
image : l’image officielle de Grafana (édition open source) ;
restart: unless-stopped : Grafana redémarre tout seul après un reboot du serveur ;
GF_SECURITY_ADMIN_PASSWORD : définit le mot de passe du compte admin au premier démarrage ;
GF_PLUGINS_PREINSTALL : installe automatiquement un plugin (ici le panneau horloge, à titre d’exemple ; plusieurs plugins se séparent par des virgules) ;
grafana-storage : un volume Docker nommé qui conserve vos tableaux de bord et réglages, même si vous recréez le conteneur.
Étape 4 – Démarrer Grafana
docker compose up -d
Vérifiez que le conteneur tourne, et consultez les logs si besoin :
docker compose ps
docker compose logs -f grafana
Étape 5 – Se connecter
Ouvrez votre navigateur sur http://ADRESSE_IP_DU_SERVEUR:3000 (ou http://localhost:3000 en local) et connectez-vous avec l’utilisateur admin et le mot de passe défini dans le fichier .env.
Note : si vous utilisez un dossier local (« bind mount ») plutôt qu’un volume nommé, le conteneur tourne avec l’utilisateur 472 : le dossier doit lui appartenir (sudo chown -R 472:472 ./data), sinon Grafana ne pourra pas écrire ses données.
Aller plus loin : ajouter Prometheus pour superviser votre serveur
Grafana seul est une coquille vide : il lui faut des données. Le duo classique est Prometheus (qui collecte les métriques) et node_exporter (qui expose celles de la machine). Remplacez votre docker-compose.yaml par ceci :
Puis créez le fichier prometheus.yml à côté. Comme node_exporter tourne sur le réseau de l’hôte, Prometheus l’atteint via host.docker.internal (déclaré par extra_hosts dans le compose ci-dessus) :
Dans Grafana, ouvrez Connections → Data sources → Add data source.
Choisissez Prometheus.
Dans Prometheus server URL, saisissez http://prometheus:9090 (les conteneurs d’un même compose se joignent par leur nom).
Cliquez sur Save & test : un message vert confirme la connexion.
Importer un tableau de bord tout fait
Allez dans Dashboards → New → Import, saisissez l’identifiant 1860 (« Node Exporter Full », un classique de la communauté), choisissez votre source Prometheus et validez. Vous obtenez immédiatement un tableau de bord complet de votre machine.
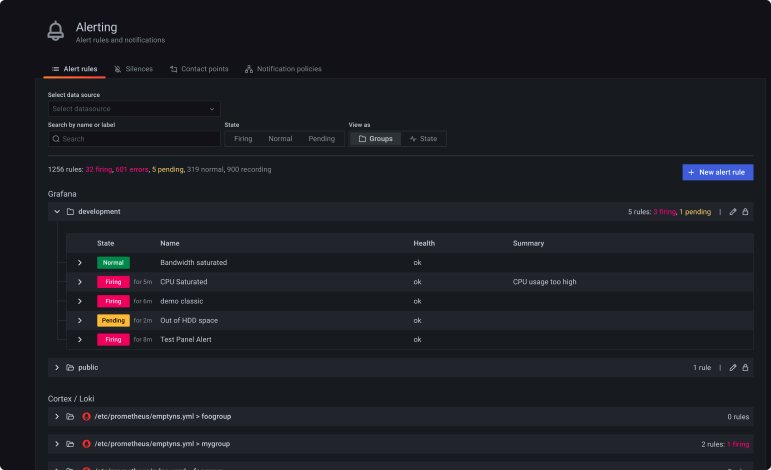
Les alertes permettent d’être prévenu en cas de problème (image : Grafana Labs)
Maintenance : mise à jour et sauvegarde
Mettre à jour Grafana :
cd ~/grafana
docker compose pull
docker compose up -d
docker image prune -f
Sauvegarder le volume de données (archive dans le dossier courant) :
docker run --rm -v grafana_grafana-storage:/data -v "$PWD":/backup alpine \
  tar czf /backup/grafana-backup-$(date +%F).tar.gz -C /data .
Le nom du volume est préfixé par celui du dossier du projet (ici grafana_grafana-storage). Vérifiez-le avec docker volume ls.
Quelques conseils de sécurité
Ne laissez jamais le mot de passe par défaut admin/admin.
N’exposez pas directement le port 3000 sur Internet : placez Grafana derrière un reverse proxy en HTTPS (Nginx, Apache, Traefik, Caddy…) ou derrière un VPN.
Pour n’autoriser que l’accès local (par exemple derrière un reverse proxy sur la même machine), remplacez "3000:3000" par "127.0.0.1:3000:3000".
Mettez à jour régulièrement l’image.
Conclusion
En quelques minutes, Docker vous permet d’avoir un Grafana fonctionnel, persistant et facile à mettre à jour. Reliez-le à Prometheus, InfluxDB ou à votre base de données, importez quelques tableaux de bord de la communauté, et vous disposez d’un véritable centre de supervision pour votre infrastructure personnelle ou professionnelle.
Les piles de courriers, les factures glissées dans un tiroir et les contrats introuvables au moment où l’on en a besoin ont une solution libre et gratuite : Paperless-ngx. Cet article explique ce que fait ce logiciel, pourquoi il vaut la peine d’être installé chez soi, et comment le déployer avec Docker Compose.
Le logo de Paperless-ngx
Qu’est-ce que Paperless-ngx ?
Paperless-ngx est un système de gestion électronique de documents (GED) libre, conçu pour l’auto-hébergement. Vous lui donnez un PDF ou une photo de document : il en extrait le texte par reconnaissance optique de caractères (OCR), l’indexe, propose un classement et conserve l’original à côté d’une version archivée.
Le projet est la suite communautaire de Paperless et de Paperless-ng. Il se déploie avant tout avec Docker, et l’image est publiée sur le registre de conteneurs GitHub.
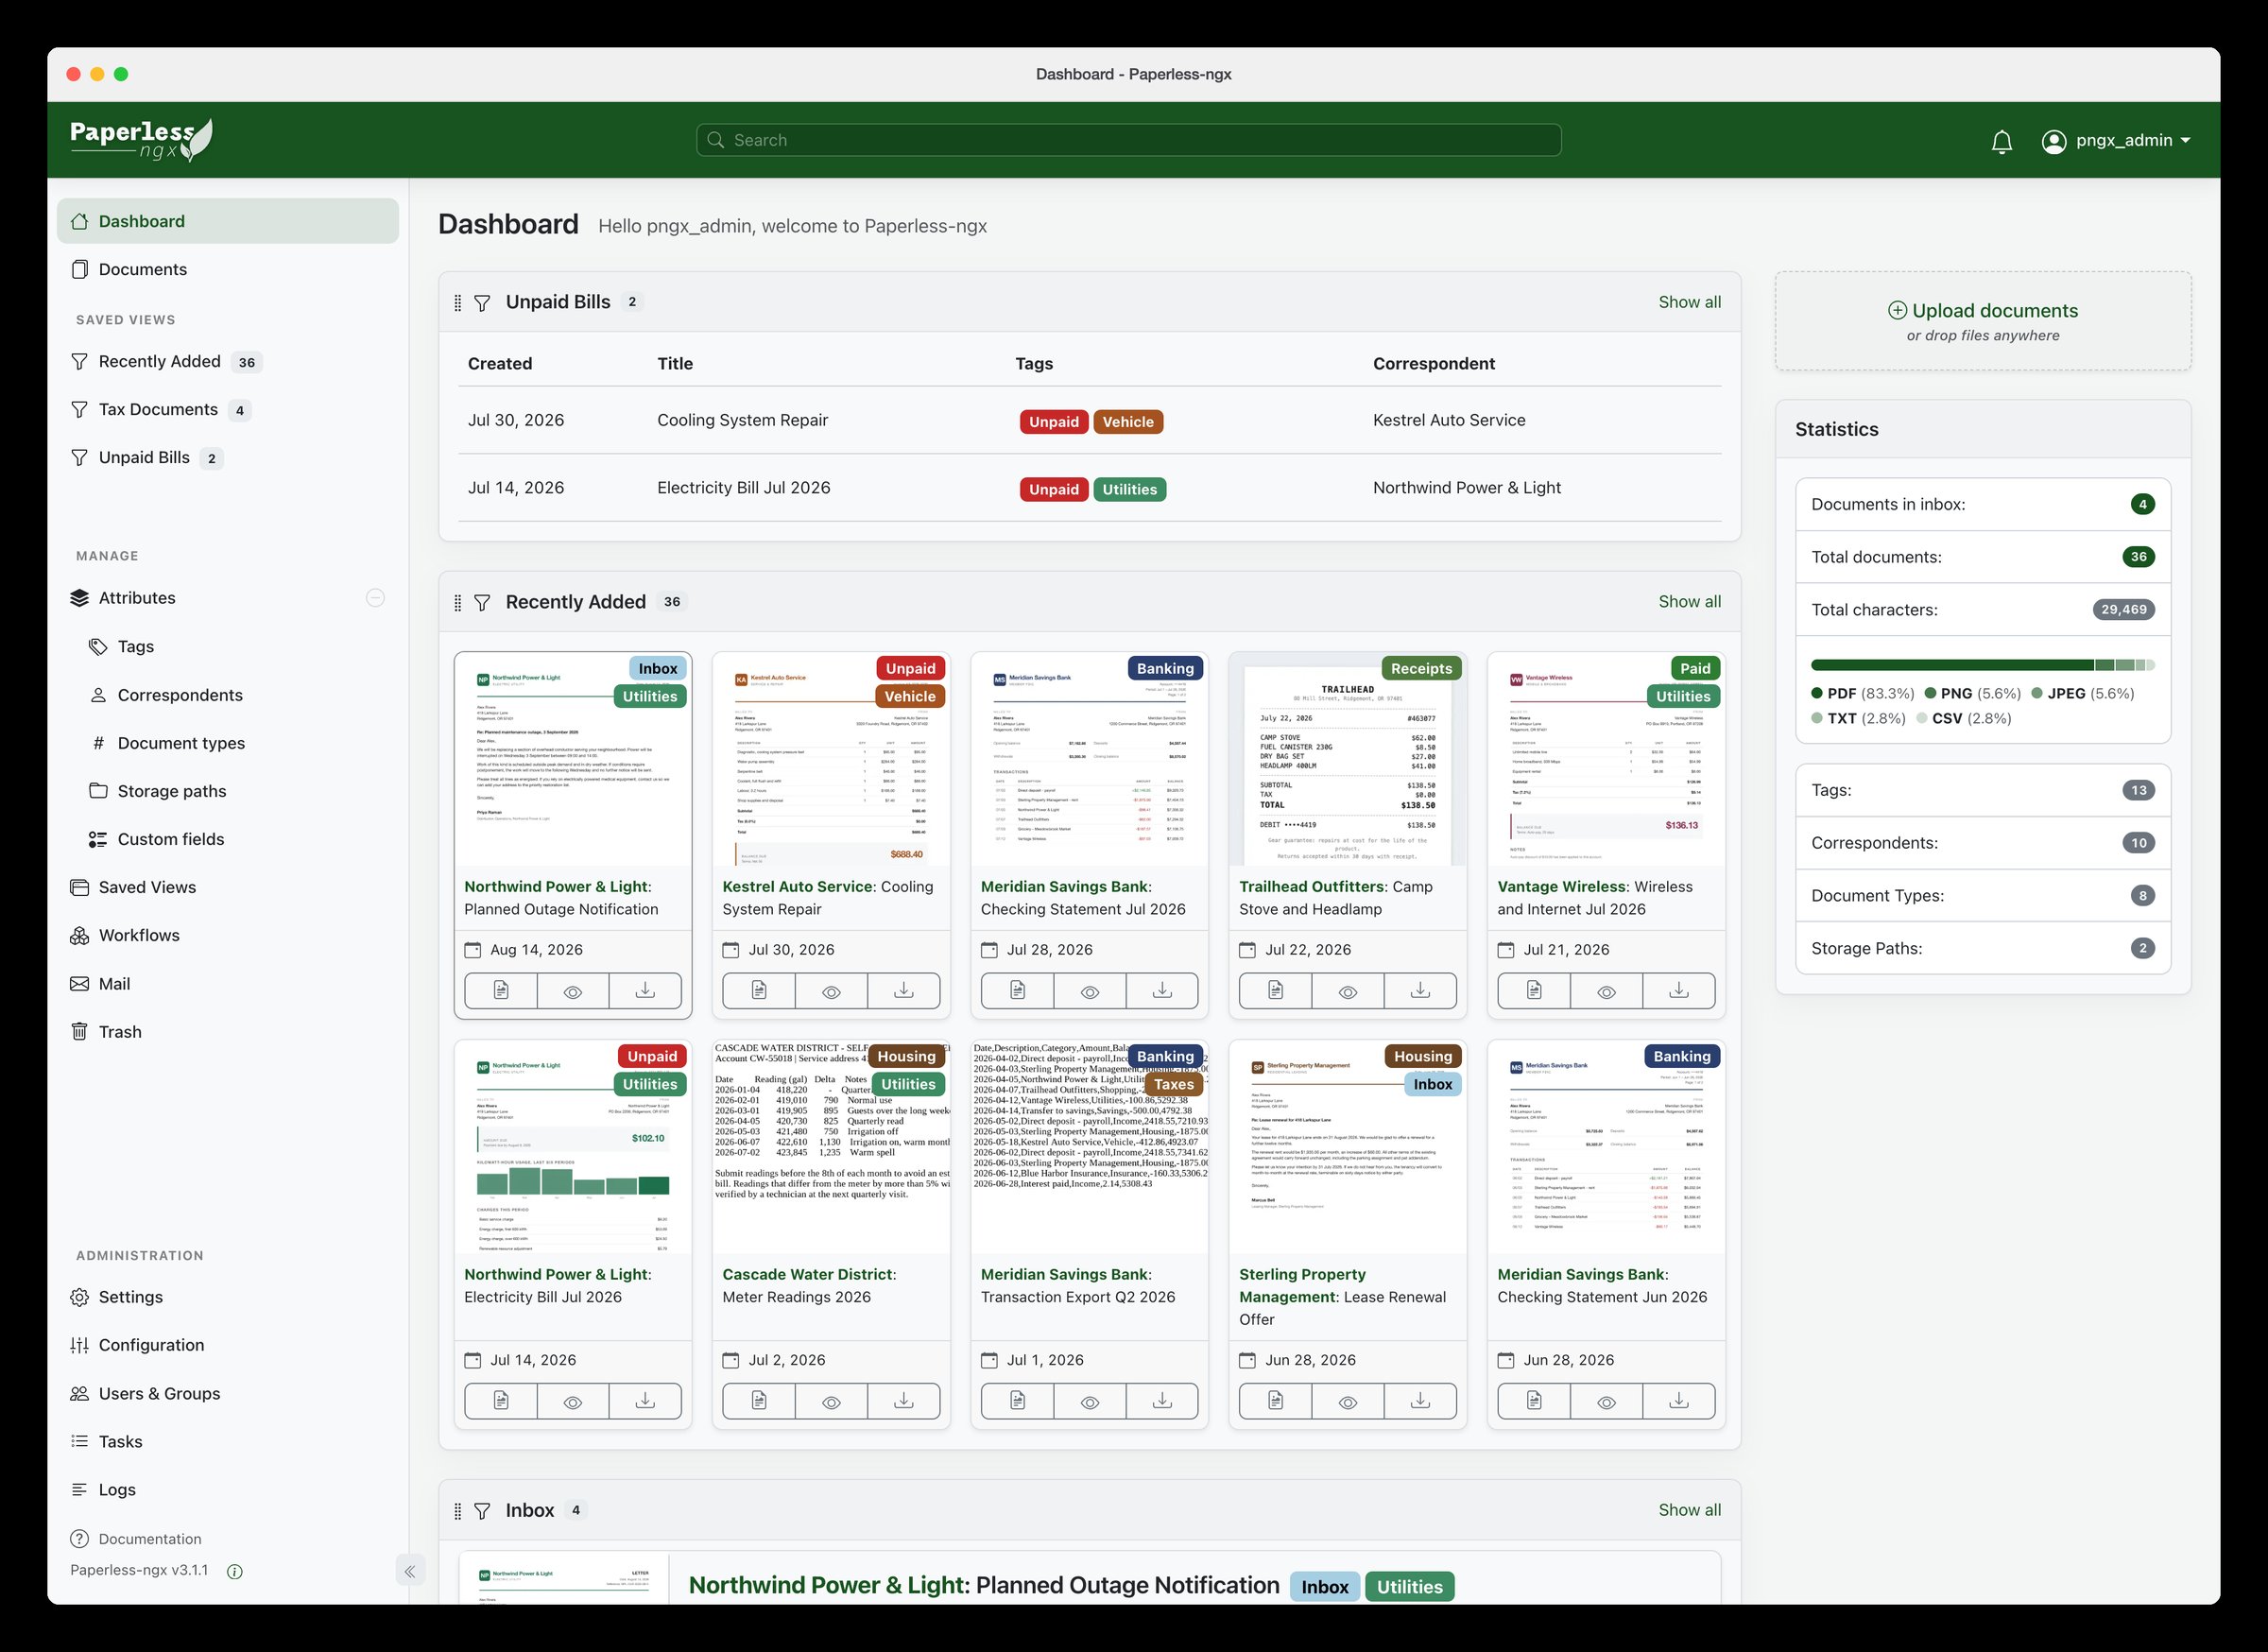
Le tableau de bord : vues enregistrées (factures impayées, documents fiscaux…), documents récents, boîte de réception et statistiques
Pourquoi l’adopter
Retrouver un document par son contenu
L’OCR rend le texte de chaque page interrogeable. Plus besoin de se rappeler du nom du fichier ou du dossier : la barre de recherche retrouve « contrat chaudière » ou un numéro de client à l’intérieur même d’un scan.
Chaque document affiche le texte extrait par l’OCR : la recherche porte sur ce contenu, pas seulement sur le titre
Un classement qui se fait presque tout seul
Chaque document peut recevoir des étiquettes, un correspondant (l’émetteur), un type de document et un chemin de stockage. Des règles de correspondance, ou un apprentissage à partir de vos propres classements, attribuent ces métadonnées automatiquement aux nouveaux documents. Le tri manuel se limite aux cas inédits.
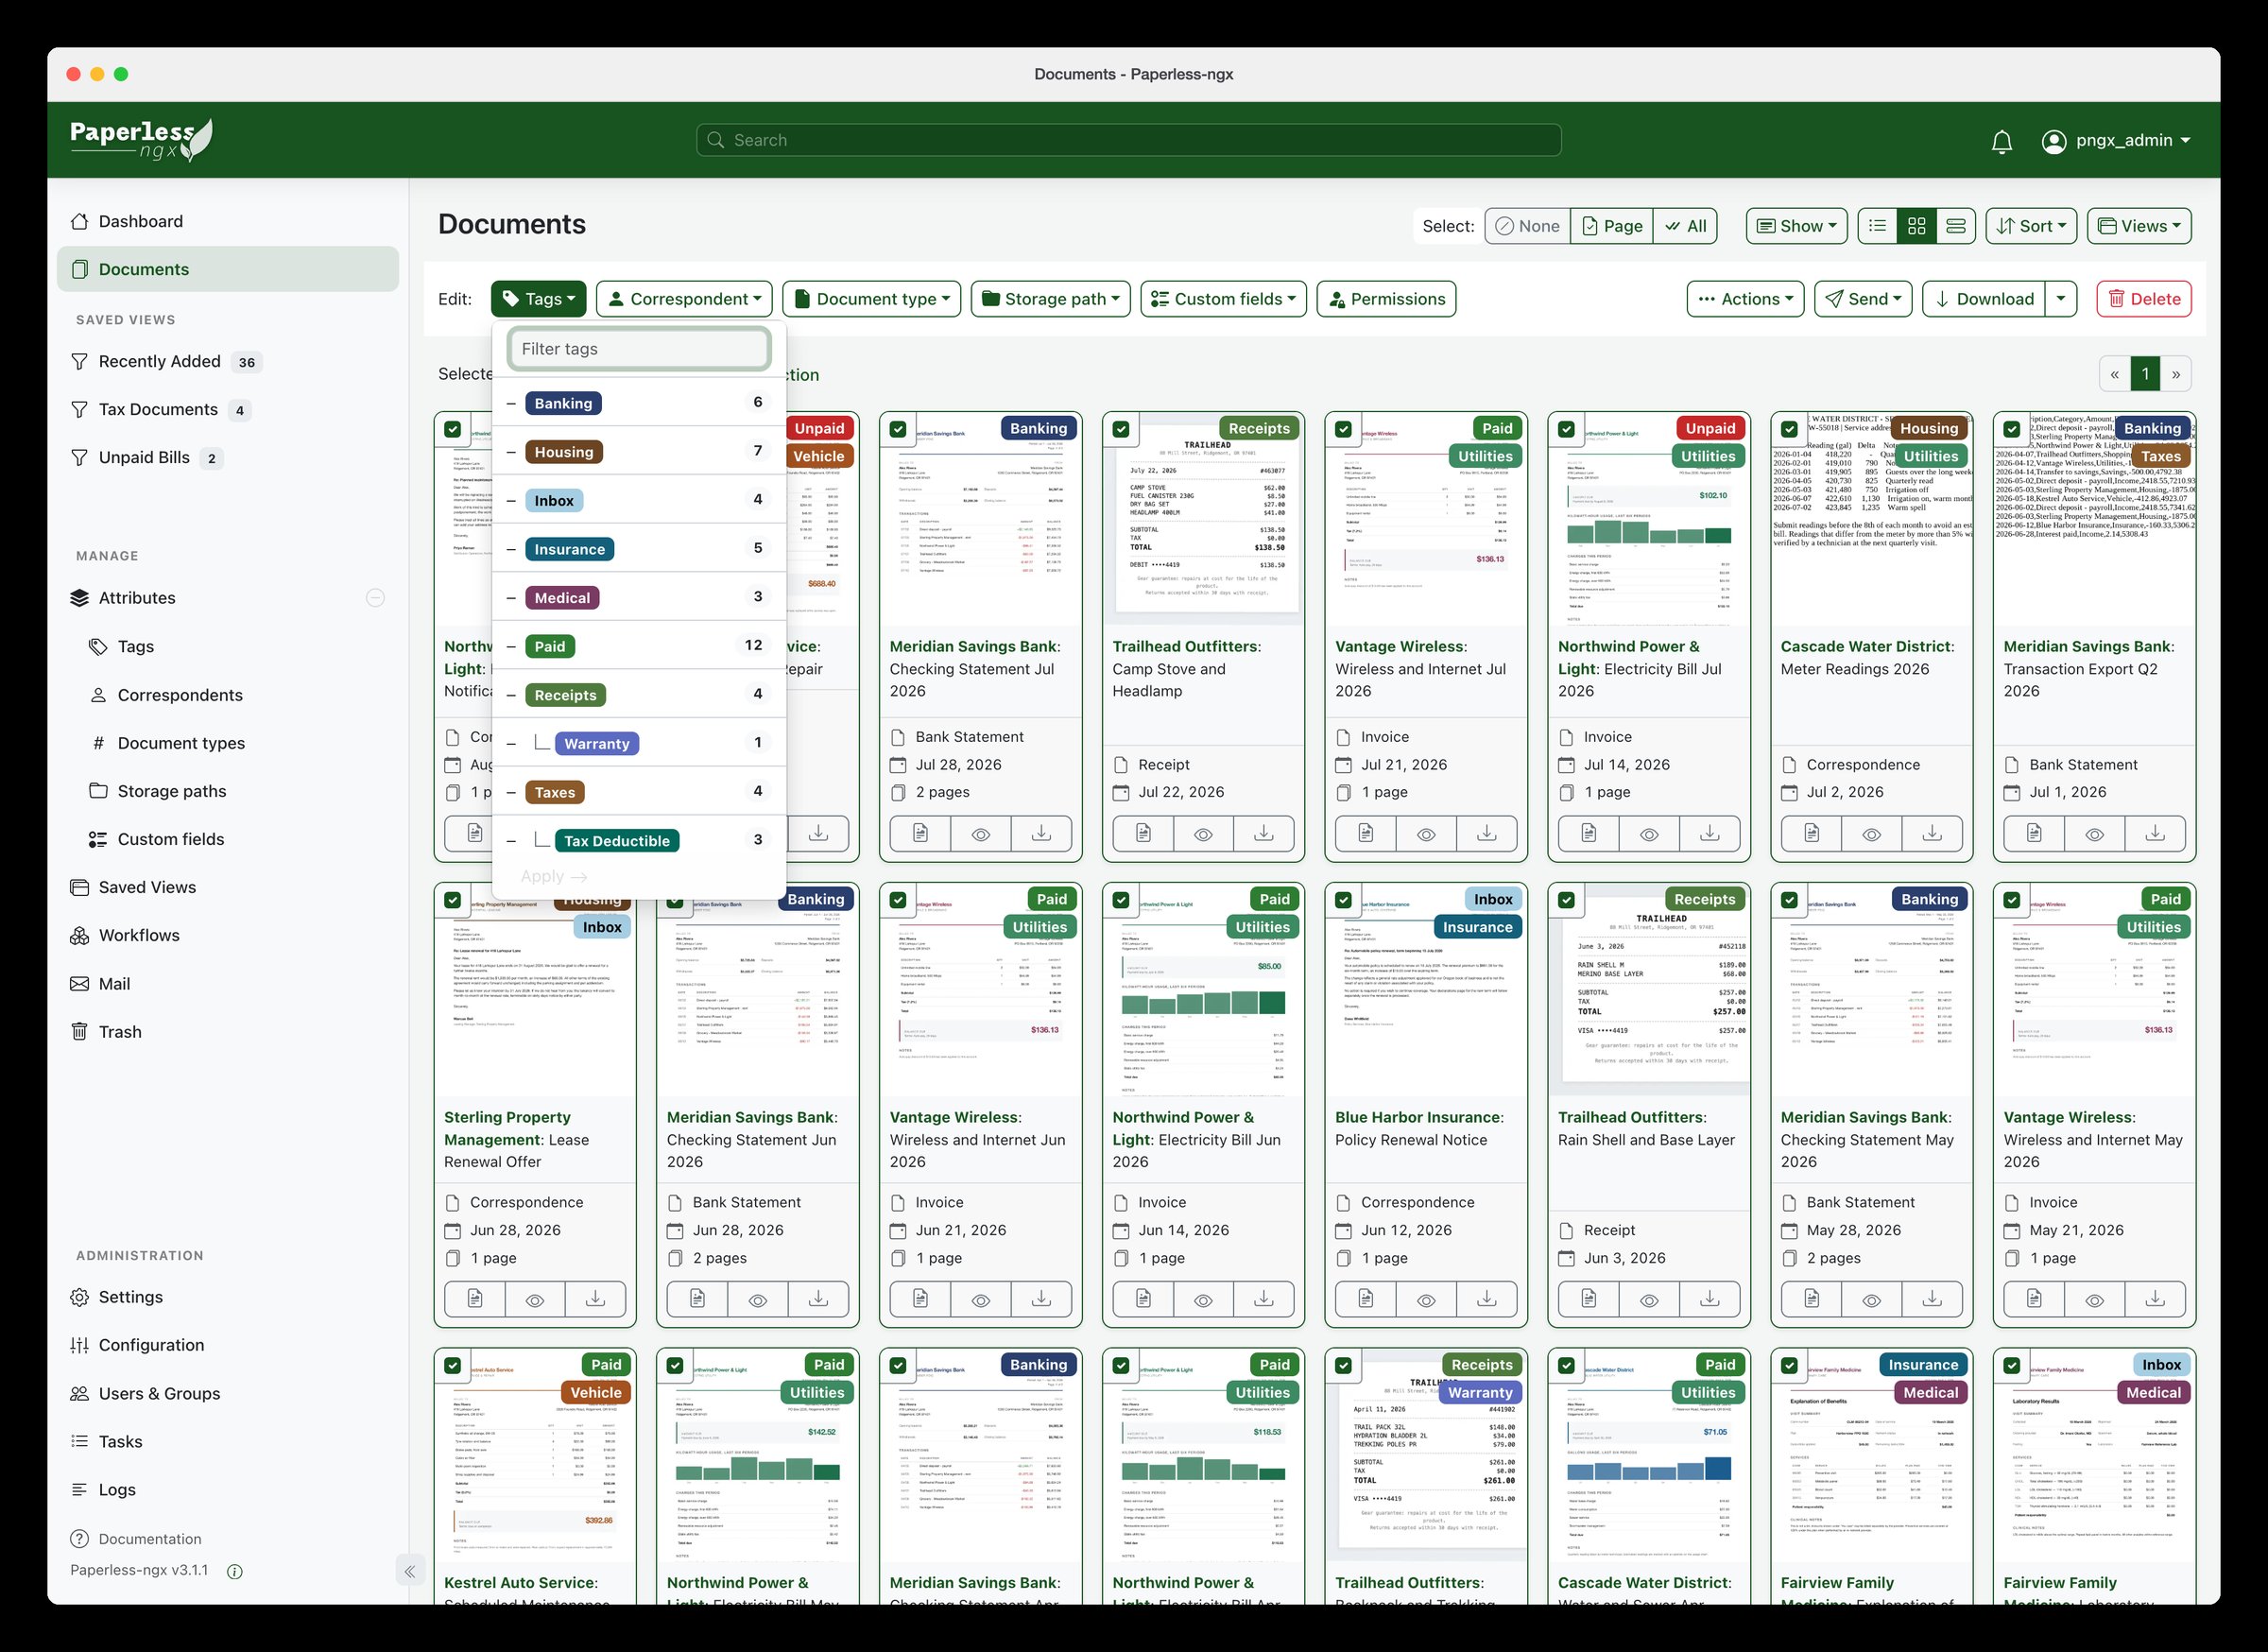
Édition en lot : on sélectionne plusieurs documents puis on leur applique une étiquette, un correspondant ou un type d’un seul geste
Une porte d’entrée pour tous vos papiers
Dossier surveillé : tout fichier déposé dans le dossier consume est traité. Un scanner réseau qui envoie vers un partage SMB ou NFS suffit à alimenter la GED.
Boîtes e-mail : des règles de messagerie récupèrent les pièces jointes (factures, relevés) et les classent.
Glisser-déposer depuis l’interface web, et une API REST pour les automatisations et applications tierces.
Des documents vivants, pas un simple dépôt de PDF
Champs personnalisés (montant, échéance, numéro de compte), notes, versions d’un document, vues enregistrées affichées sur le tableau de bord, workflows déclenchés à l’arrivée ou à la modification d’un document : l’outil sert aussi de pense-bête administratif, par exemple pour suivre les factures impayées.
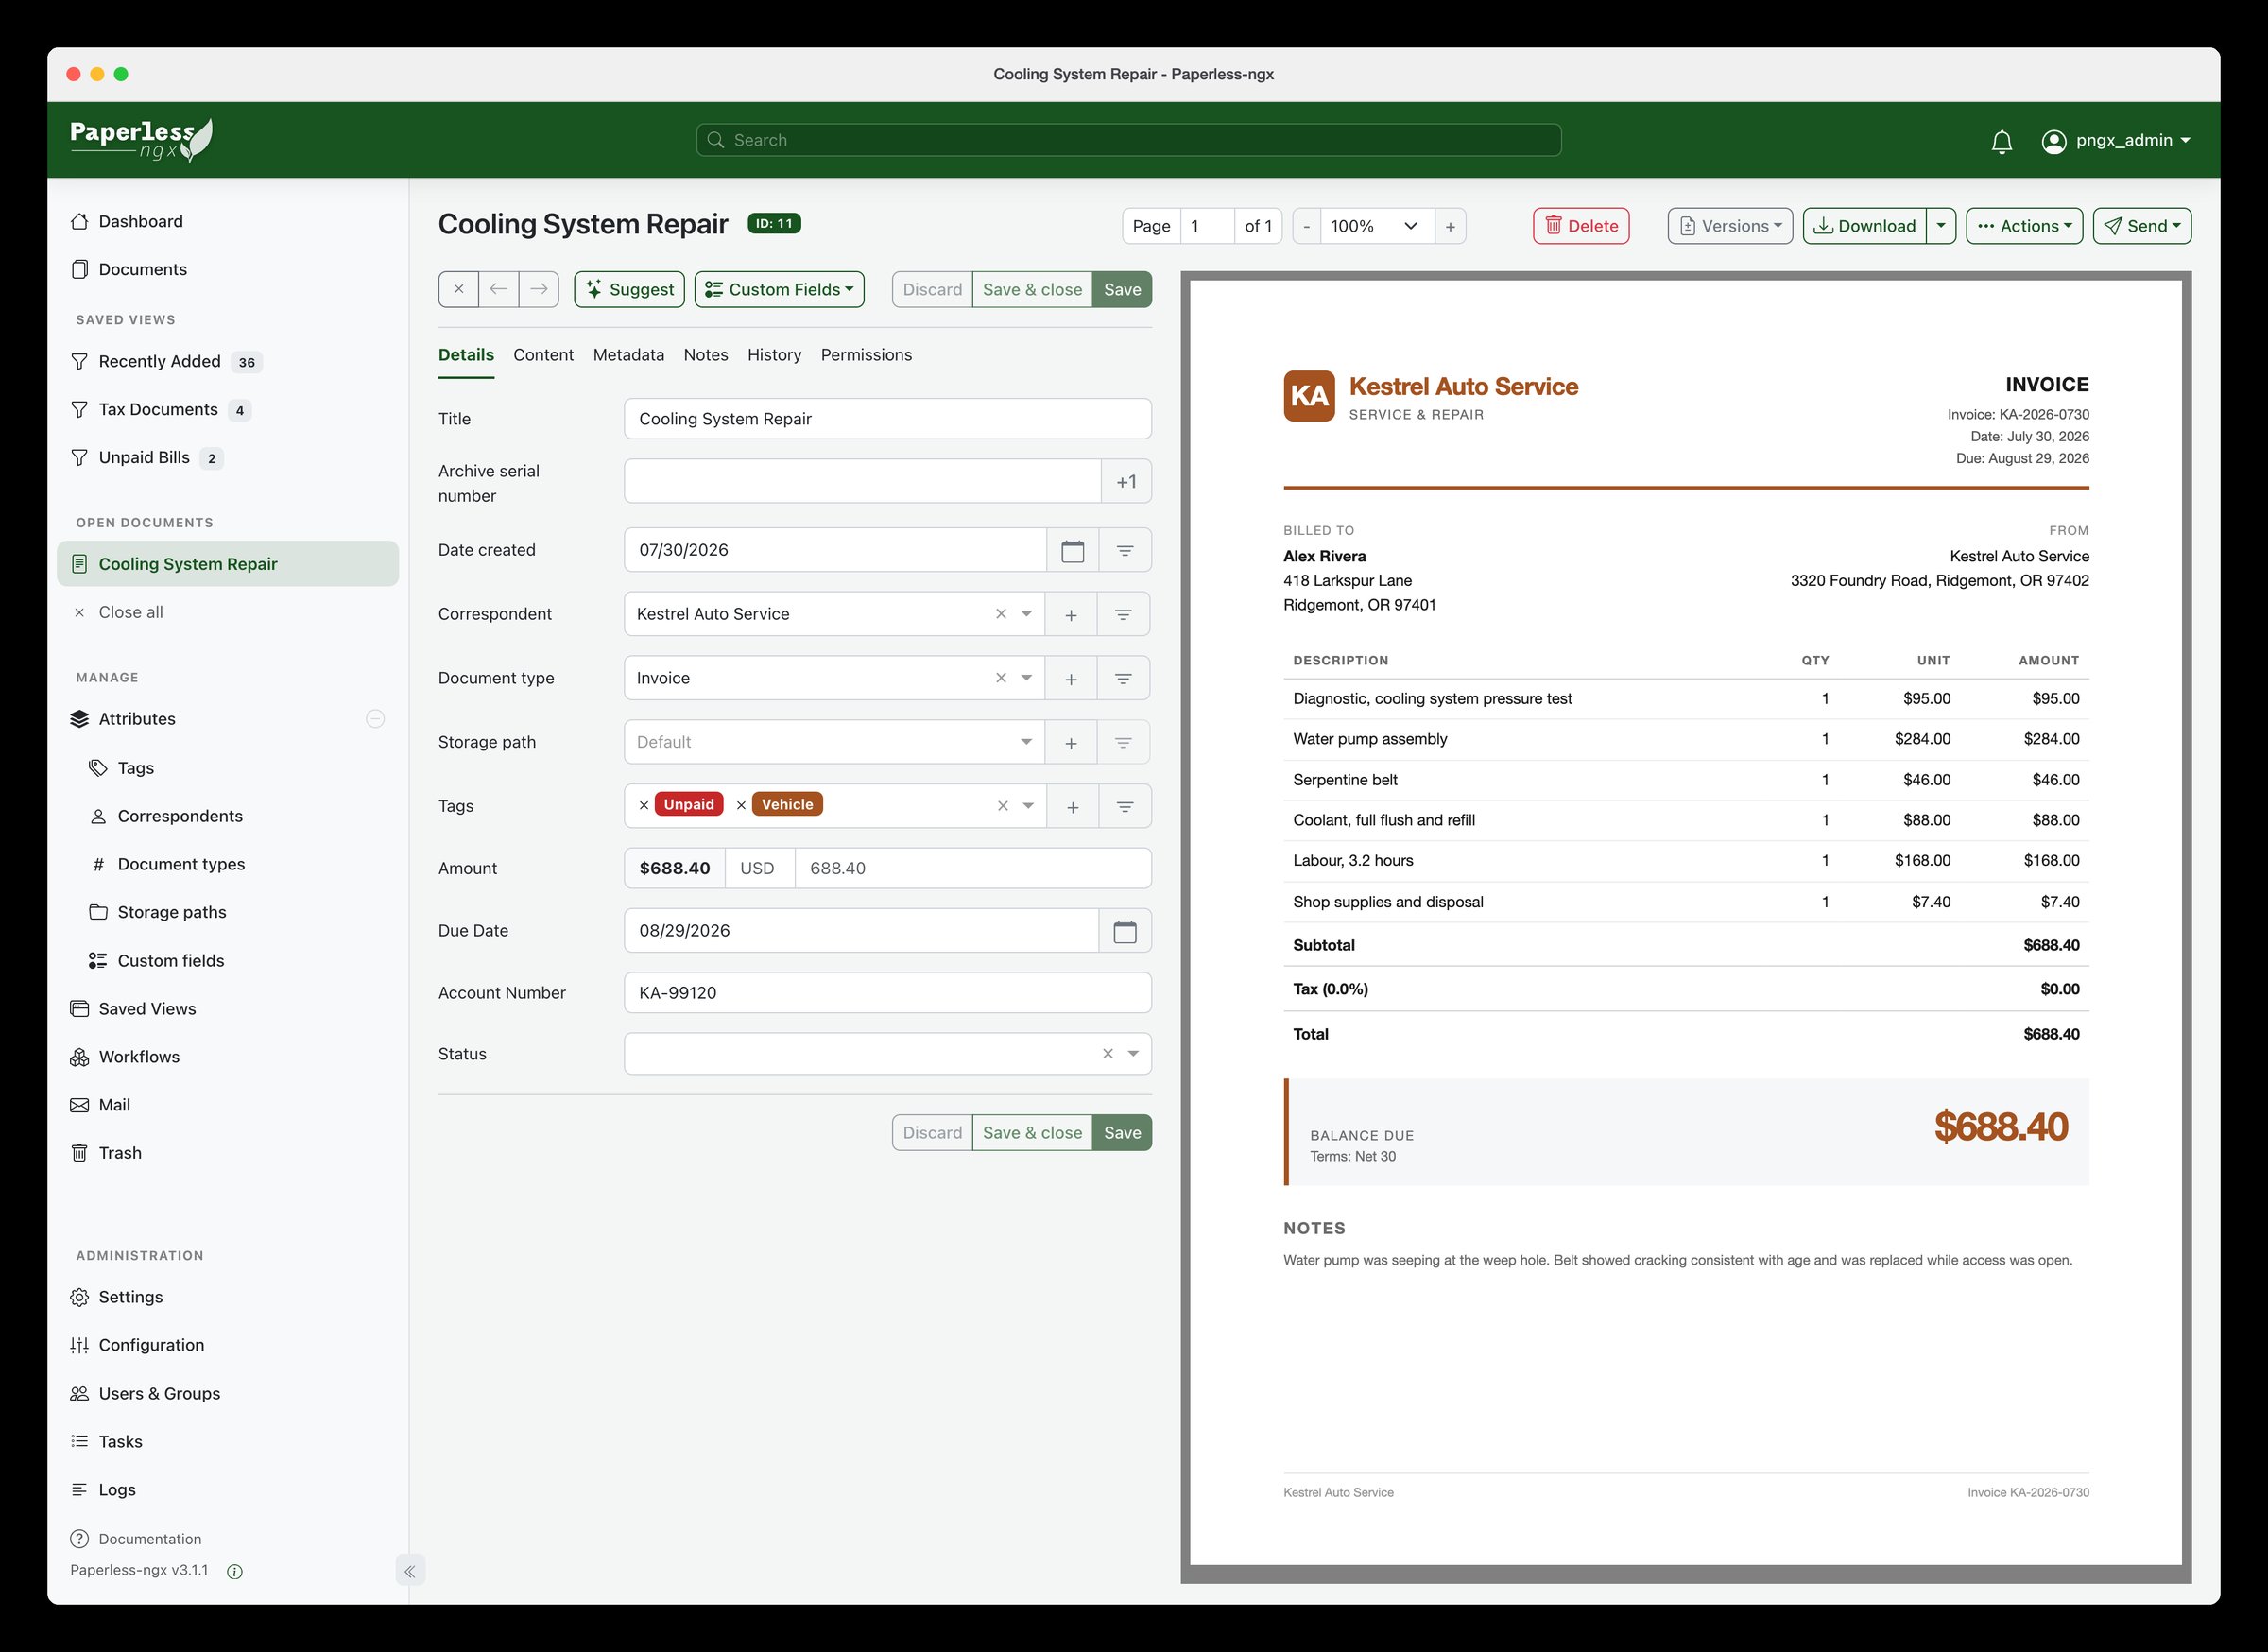
La fiche d’un document : métadonnées et champs personnalisés à gauche, aperçu du fichier à droite
Vos données restent chez vous
Aucun abonnement, aucun envoi vers un cloud tiers : les documents sont stockés sur votre serveur. L’application gère plusieurs utilisateurs avec des droits par document, ce qui permet de partager une GED familiale tout en gardant certains dossiers privés. Le contenu est stocké dans des formats ouverts, et un export complet est intégré.
Prérequis
Un serveur ou mini-PC sous Linux (ou un NAS compatible Docker) ; Paperless-ngx tourne sur architectures amd64, arm et arm64.
De la marge en mémoire et en processeur : l’OCR est gourmand, surtout lors de l’import d’une grosse archive. Prévoyez plusieurs Go de RAM libres.
De l’espace disque pour les originaux et les versions archivées, soit grossièrement le double de vos fichiers.
Installation avec Docker Compose
Deux voies existent. Dans les deux cas, on obtient la même pile de trois conteneurs : webserver (l’application), db (PostgreSQL, recommandé pour une nouvelle installation) et broker (file de tâches Valkey, compatible Redis).
Option 1 : le script d’installation (le plus rapide)
Le projet fournit un script interactif qui pose quelques questions (port, dossier de données, base de données, fuseau horaire, langue de l’OCR, utilisateur administrateur), télécharge les fichiers et lance la pile :
Attention : comme pour tout script lancé directement depuis Internet, lisez-le d’abord (par exemple avec curl -L …/install-paperless-ngx.sh | less) pour voir ce qu’il fait.
Option 2 : installation manuelle, pas à pas
Cette voie donne la maîtrise complète des fichiers et s’intègre mieux à une gestion par dépôt Git ou par Portainer.
Pour lire aussi les documents Office (Word, Excel, LibreOffice), prenez à la place le fichier docker-compose.postgres-tika.yml, qui ajoute les conteneurs Tika et Gotenberg.
3. Vérifier le docker-compose.yml. Voici, sans ses commentaires, la version officielle au moment de la rédaction :
8000:8000 : le port de gauche est celui exposé sur votre machine. Changez-le (par exemple 8283:8000) si 8000 est déjà pris.
./consume et ./export sont des dossiers visibles sur l’hôte ; data et media sont des volumes gérés par Docker. Pour garder tous les documents dans un dossier précis (un montage NAS, par exemple), remplacez media:/usr/src/paperless/media par /chemin/vers/media:/usr/src/paperless/media.
Le mot de passe PostgreSQL par défaut est paperless. La base n’est pas exposée hors du réseau Docker, mais si vous le changez, modifiez aussi PAPERLESS_DBPASS dans le service webserver.
4. Régler le fichier d’environnement. Ouvrez docker-compose.env : seule la clé secrète est active par défaut, et elle doit être remplacée.
docker compose pull
docker compose up -d
docker compose ps
Le premier démarrage prend une à deux minutes (migrations de la base). Suivez-le avec docker compose logs -f webserver.
6. Créer le compte administrateur
docker compose run --rm webserver createsuperuser
Saisissez l’identifiant, l’e-mail (facultatif) et le mot de passe, puis ouvrez http://ADRESSE_DU_SERVEUR:8000 et connectez-vous. Le compte créé ici est le seul au départ.
Réglages à faire dès le départ
Variable
Rôle
PAPERLESS_SECRET_KEY
Clé de signature des sessions. À changer absolument et à conserver : la modifier déconnecte tous les utilisateurs.
PAPERLESS_TIME_ZONE
Fuseau horaire utilisé pour les dates des documents (Europe/Paris).
PAPERLESS_OCR_LANGUAGE
Langues de l’OCR. fra+eng pour des documents en français et en anglais ; la valeur par défaut est eng, ce qui dégrade la reconnaissance des accents.
PAPERLESS_OCR_LANGUAGES
Paquets de langues supplémentaires à installer dans le conteneur, pour les langues absentes de l’image de base.
PAPERLESS_URL
URL publique, indispensable derrière un reverse proxy HTTPS.
USERMAP_UID / USERMAP_GID
Identifiants de l’utilisateur Linux qui doit être propriétaire des fichiers des dossiers montés (id -u et id -g).
Après toute modification du fichier d’environnement, docker compose up -d recrée le conteneur avec les nouvelles valeurs.
Premiers pas
Déposer des documents : glissez-les dans l’interface, ou copiez-les dans /opt/paperless/consume. Ils apparaissent après traitement, avec l’étiquette « Inbox » si elle existe.
Créer vos attributs dans Gérer : correspondants (EDF, impôts, banque), types (facture, contrat, relevé), étiquettes. Pour chacun, choisissez l’algorithme de correspondance : « Automatique » s’appuie sur ce que vous avez déjà classé.
Corriger les premiers classements : l’apprentissage automatique s’affine avec vos corrections. Quelques dizaines de documents suffisent à améliorer nettement les propositions.
Enregistrer des vues (documents fiscaux, factures impayées) et les épingler sur le tableau de bord.
Brancher le scanner ou une règle de messagerie pour automatiser l’arrivée des documents.
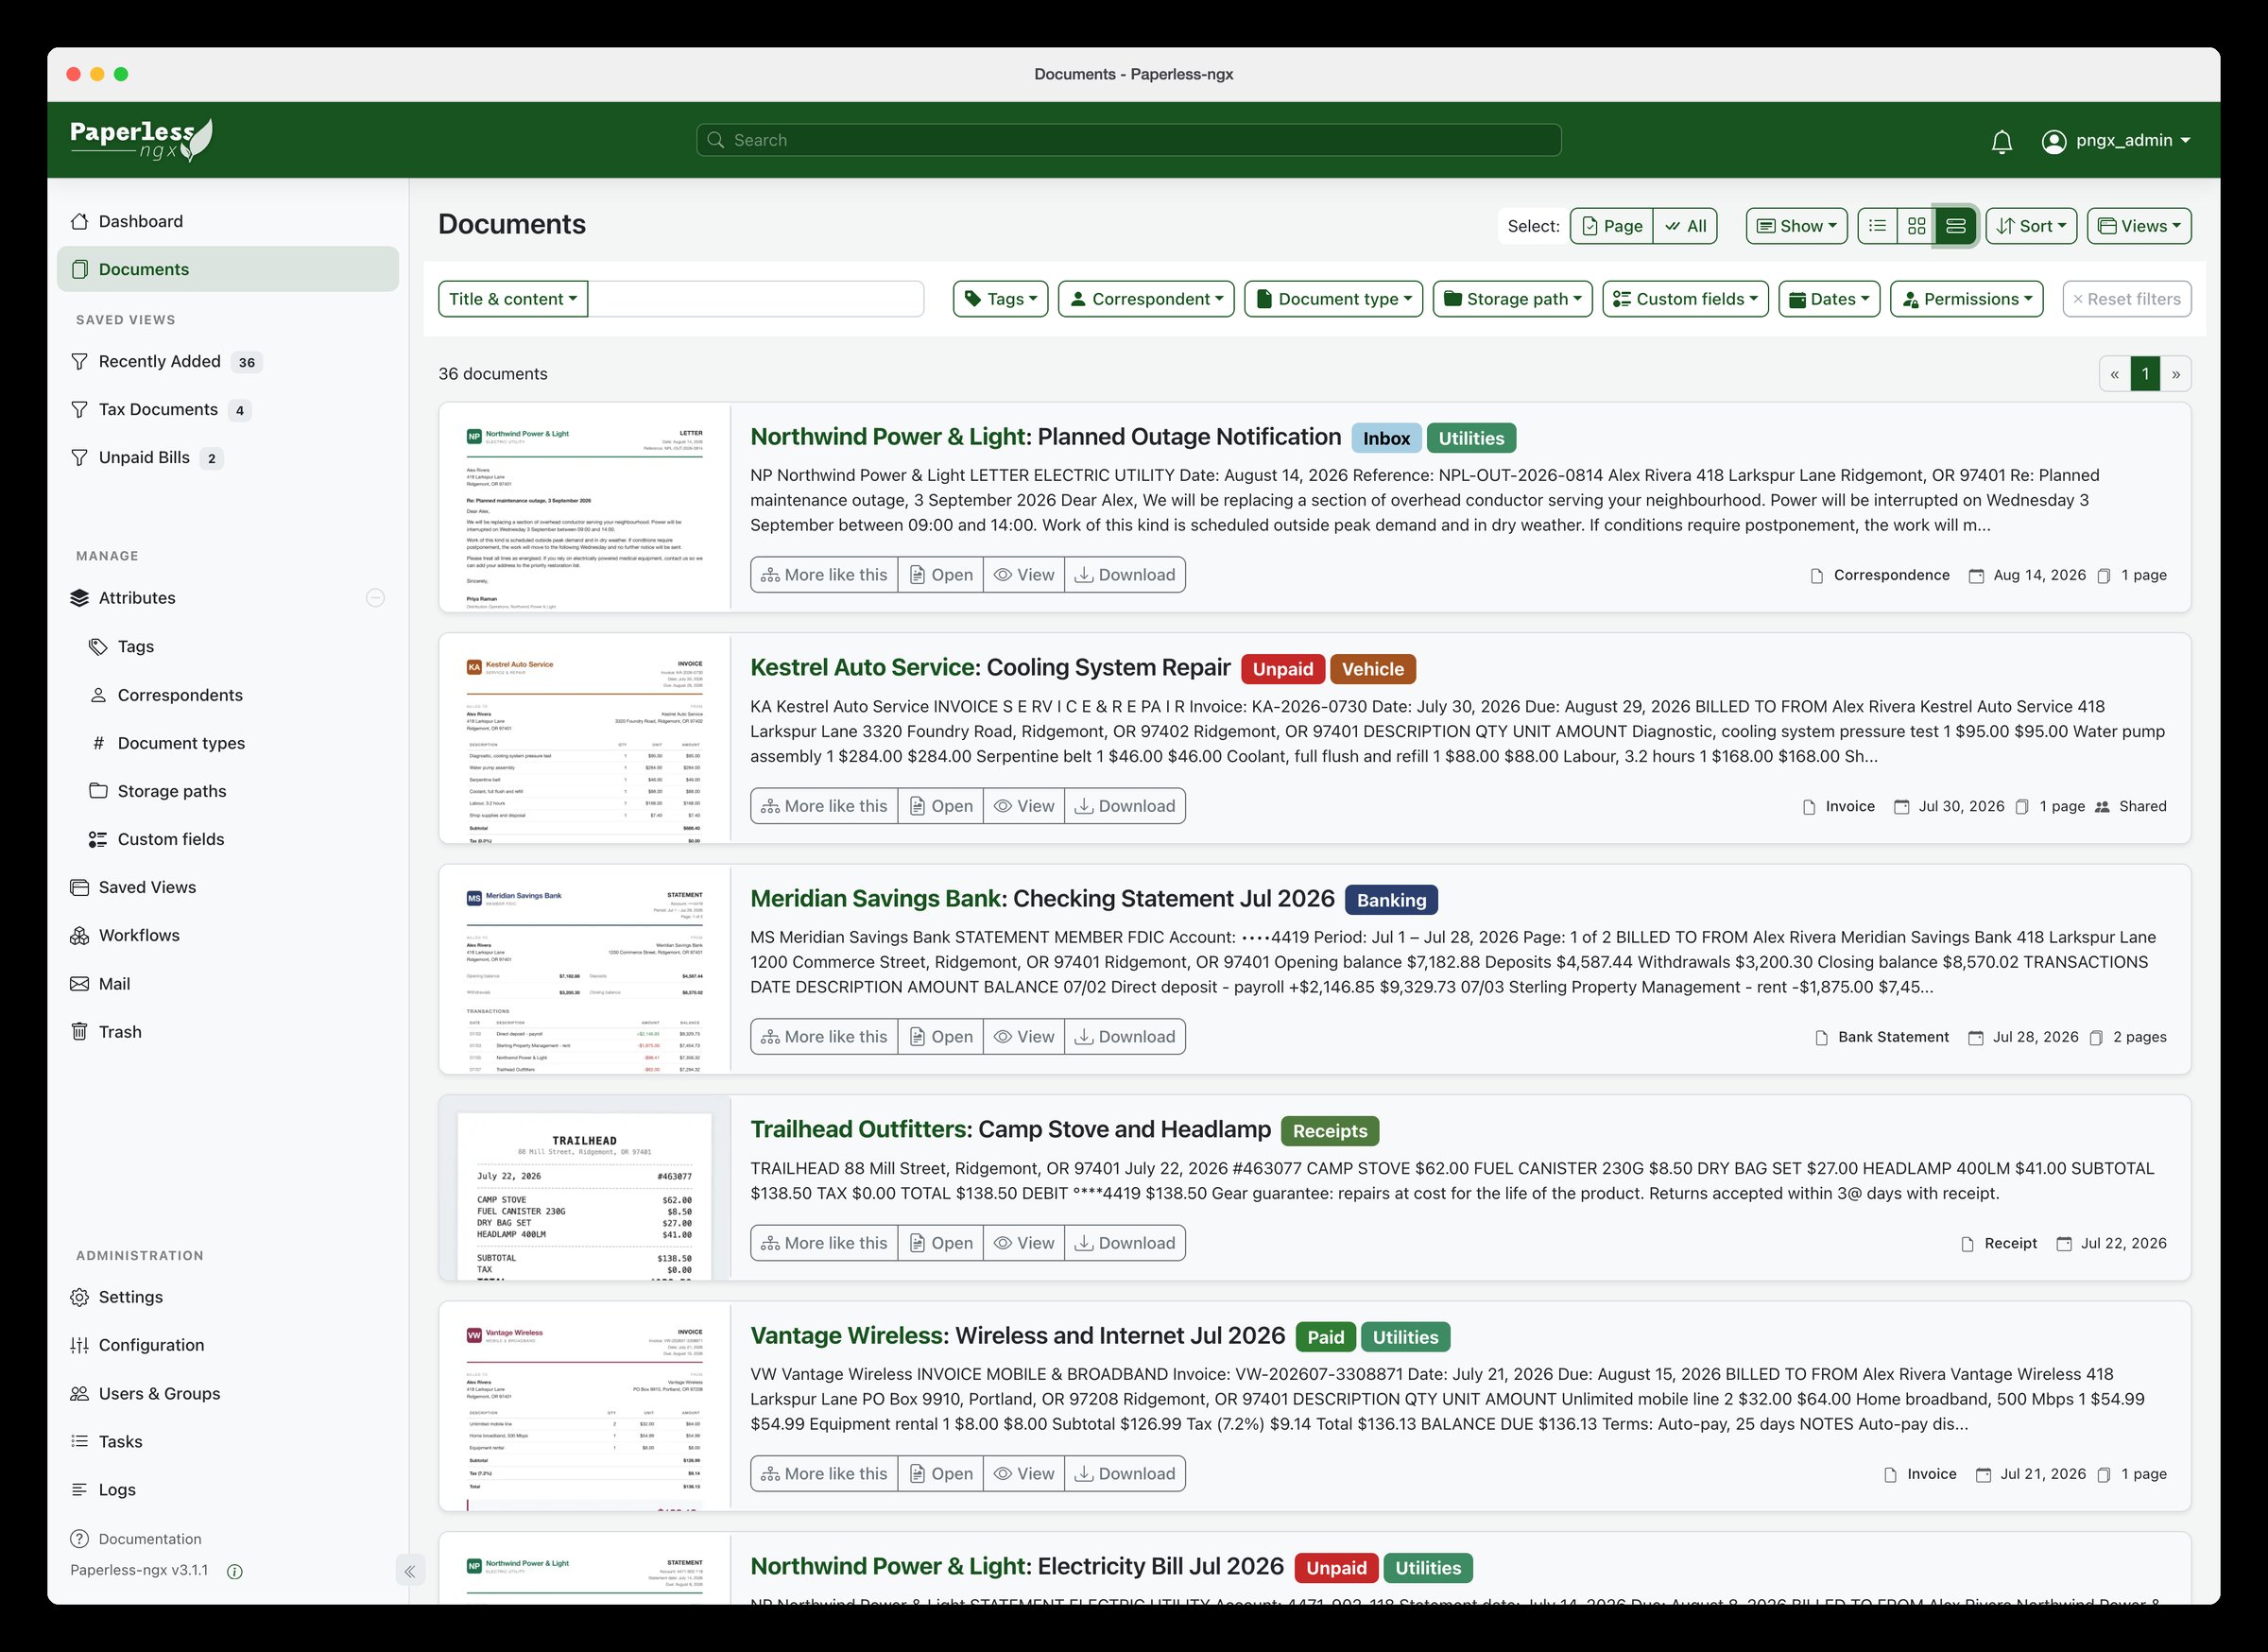
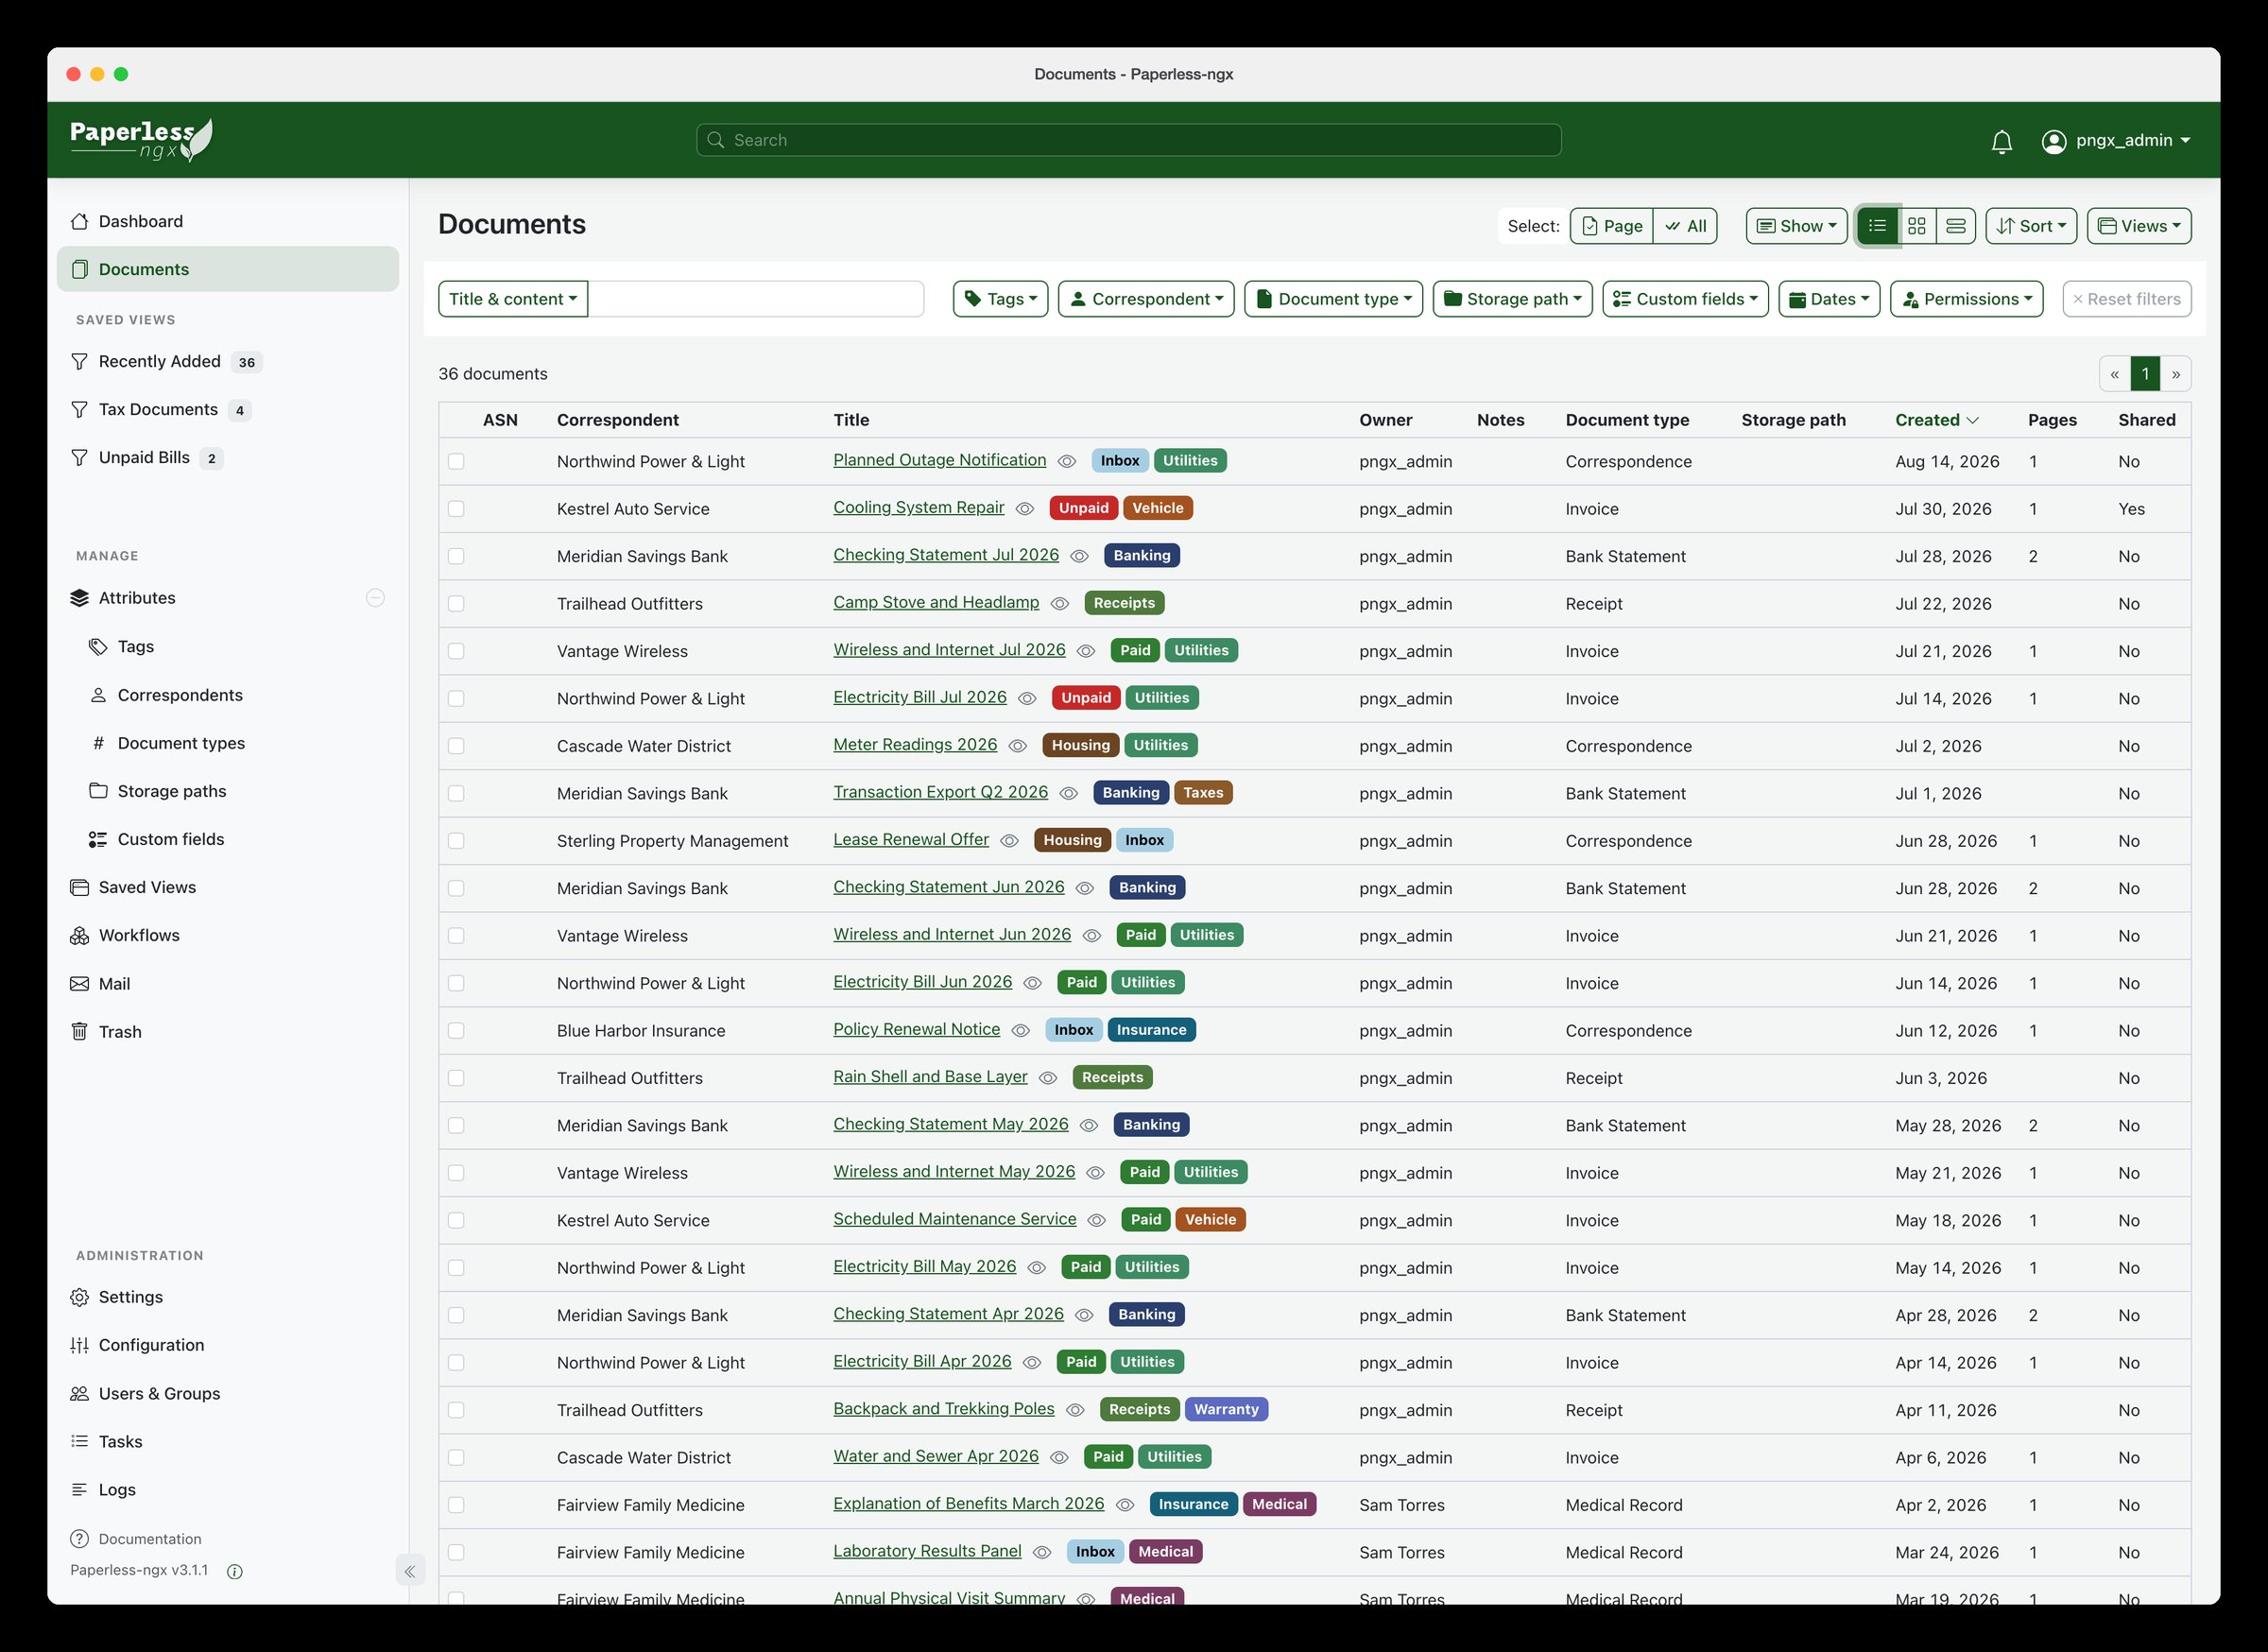
Affichage en tableau : filtres par titre et contenu, étiquettes, correspondant, type de document, dates et permissions
📷 IMAGE 6 À INSÉRER ICI : fichier paperless-06-liste-tableau.jpg (bloc Image, puis « Lier au média »). Texte alternatif : Liste des documents en tableau avec filtres par étiquette, correspondant, type et dates. Légende : Affichage en tableau : filtres par titre et contenu, étiquettes, correspondant, type de document, dates et permissions. (supprimer ce paragraphe après insertion)
Sauvegarde et mise à jour
Sauvegarder
Ne vous contentez pas de copier les volumes Docker pendant que la base tourne. Utilisez l’exporteur intégré, qui produit les fichiers d’origine, les métadonnées et un manifeste restaurable :
Le résultat se trouve dans /opt/paperless/export : copiez ce dossier vers un second support, de préférence hors de la machine. Vous pouvez planifier la commande par cron chaque nuit. Pour restaurer, le conteneur propose la commande symétrique document_importer.
Gardez aussi une copie de docker-compose.yml, de docker-compose.env (clé secrète comprise) et du fichier .env.
Mettre à jour
cd /opt/paperless
docker compose pull
docker compose up -d
Lisez les notes de version avant un changement de version majeure : certaines évolutions de la base demandent une manipulation. Pour éviter les surprises, remplacez latest par un numéro de version précis dans le fichier compose et montez-le vous-même.
Sécurité et accès distant
Ne publiez pas le port 8000 directement sur Internet. Placez un reverse proxy HTTPS (Nginx, Apache, Caddy, Traefik) devant, et renseignez PAPERLESS_URL.
Pour un usage purement domestique, un VPN (WireGuard, Tailscale, ZeroTier) donne accès à la GED depuis l’extérieur sans l’exposer.
Créez un compte par personne plutôt que de partager le compte administrateur, et utilisez les permissions par document pour les dossiers sensibles.
Vos documents contiennent des données personnelles et financières : chiffrez le support des sauvegardes.
Pour conclure
Une heure suffit pour monter Paperless-ngx : quelques fichiers, trois conteneurs, un compte administrateur. Le vrai gain vient ensuite, quand un courrier numérisé retrouve tout seul son étiquette, son correspondant et sa date. Une fois l’habitude prise, le papier passe au scanner dès son arrivée et la question « où ai-je mis cette facture ? » disparaît.
Si votre maison brûle ou est cambriolée, pourrez-vous dire à votre assureur ce que vous possédiez, combien ça valait et où c’était rangé ? La plupart d’entre nous répondraient « à peu près ». HomeBox est un outil libre, léger et auto-hébergé qui sert précisément à remplacer ce « à peu près » par un inventaire précis, avec photos, factures et notices.
À quoi sert HomeBox ?
HomeBox est un système d’inventaire et d’organisation pensé pour les particuliers. C’est la suite du projet HomeBox d’origine, aujourd’hui maintenue par SysAdmins Media sous licence AGPL v3. Il est écrit en Go, utilise SQLite et embarque son interface web : un seul conteneur suffit, sans base de données externe à administrer.
Ses usages typiques :
Justifier un sinistre auprès de l’assurance : liste des biens, photos, prix et dates d’achat, numéros de série, factures et garanties au même endroit.
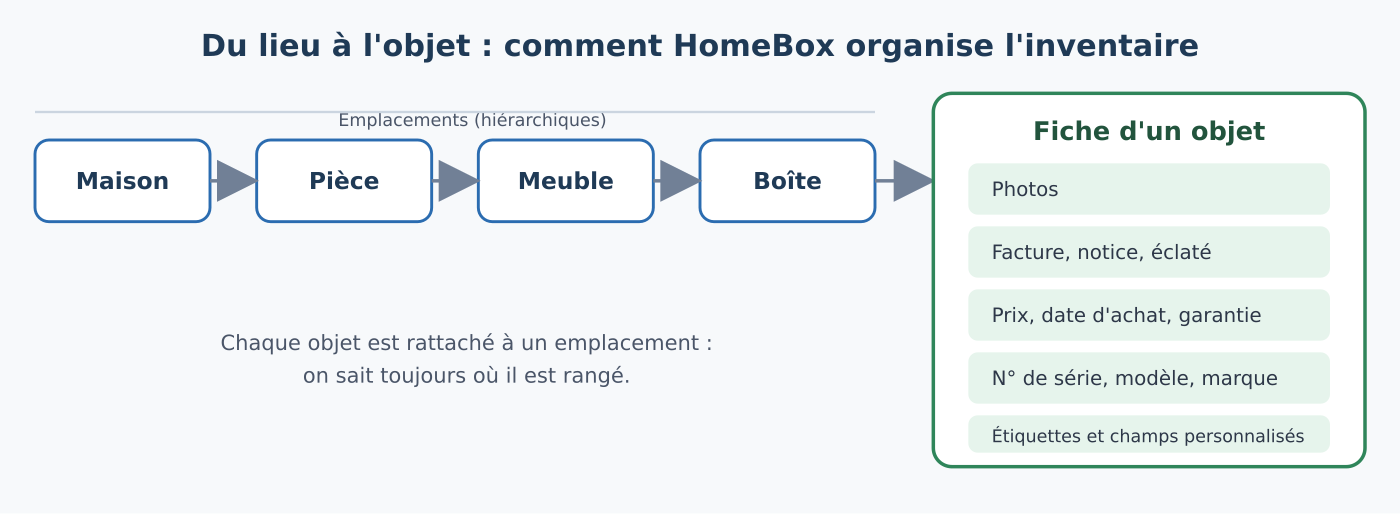
Savoir où sont les choses : chaque objet est rattaché à un emplacement (pièce, meuble, étagère, boîte), ce qui évite le « on en a déjà un quelque part ».
Suivre garanties et entretien : dates d’achat, fin de garantie, échéances de maintenance.
Conserver la documentation : notices, éclatés, catalogues, manuels, joints directement à la fiche de l’objet.
Gérer un atelier ou une collection : outillage, machines, composants, avec des champs personnalisés (référence, marque, état, etc.).
Ce qu’il fait concrètement
Organisation par emplacements (hiérarchiques), étiquettes et champs personnalisés.
Recherche rapide dans tout l’inventaire.
Photos et pièces jointes (documents, garanties, factures).
Informations d’achat : date, prix, vendeur, durée de garantie.
Import et export CSV : on peut partir d’un tableur existant et ressortir ses données à tout moment.
Génération d’étiquettes avec QR code à coller sur les boîtes et les rangements.
Interface utilisable sur ordinateur, tablette et téléphone.
API REST, point de contrôle de santé (utile pour la supervision) et client MQTT pour les intégrations domotiques.
Pourquoi l’auto-héberger ?
Un inventaire pour l’assurance contient la liste de tout ce qui a de la valeur chez vous, avec photos. C’est typiquement une donnée que l’on préfère garder chez soi plutôt que sur un service tiers. Il n’y a ni abonnement, ni limite d’objets, ni suivi. Contrepartie : la sauvegarde devient votre responsabilité, et il faut qu’elle soit hors de la maison, sinon un incendie emporte l’inventaire avec le reste (voir la section sauvegarde).